Ihr eigenes Modell: trainieren, versionieren, bereitstellen
Wenn kein fertiger Service und kein Prompt die Aufgabe löst, trainieren oder feinjustieren Sie ein Modell mit Ihren Daten und stellen es selbst bereit. Eine ML-Plattform gibt Ihnen überall dieselben sechs Schritte.


Was gehört zu einem eigenen Modell?
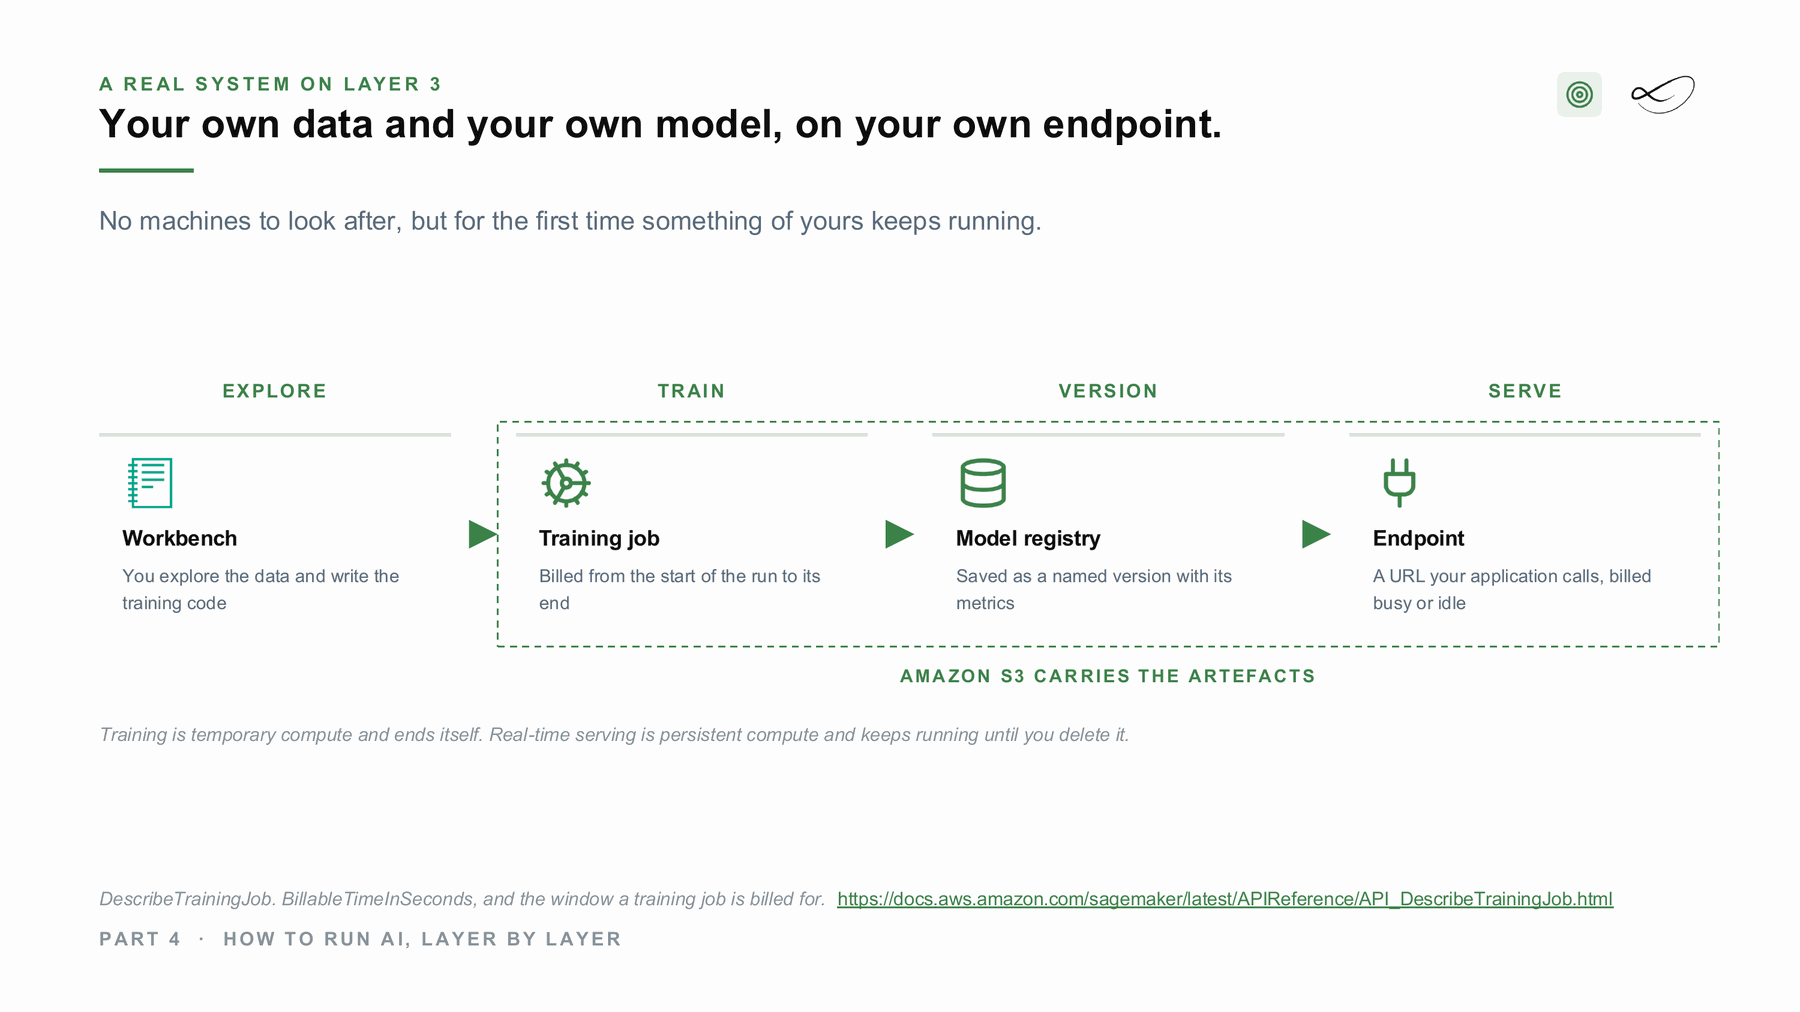
Die sechs Schritte sind immer dieselben: im Notebook entwickeln, mit Ihren Daten trainieren oder feinjustieren, das Ergebnis als Version registrieren, auf einen Endpunkt oder Batch-Job ausrollen, überwachen und prüfen, ob es mit den Daten dieses Monats noch gut genug ist. Ein Modell wird nie nur einmal ausgeliefert.
Training ist temporäre Rechenleistung, die von selbst endet. Ein Echtzeit-Endpunkt ist dauerhafte Rechenleistung, die auch beim Warten kostet. Eigene Gewichte heißen nicht, eine eigene Maschine zu haben: Ein kleines feinjustiertes Modell lässt sich auch in einen verwalteten Service importieren und pro Nutzung abrechnen.
Vier Wege, sie zu betreiben
Jede der großen Clouds bietet sie als verwalteten Service an, und Sie können sie auch selbst betreiben. Dieselbe Aufgabe, eine andere Rechnung und eine andere Konsole.
Amazon SageMaker AI[1]
Die verwaltete Machine-Learning-Plattform auf AWS: Notebooks, Trainingsjobs, eine Modell-Registry und Endpunkte.
Offizielle Dokumentation →Azure Machine Learning[2]
Die verwaltete Machine-Learning-Plattform auf Microsoft Azure.
Offizielle Dokumentation →Vertex AI[3]
Die verwaltete KI-Plattform auf Google Cloud, mit Training, Modell-Registry und Endpunkten.
Offizielle Dokumentation →Red Hat OpenShift AI, Kubeflow und MLflow[4]
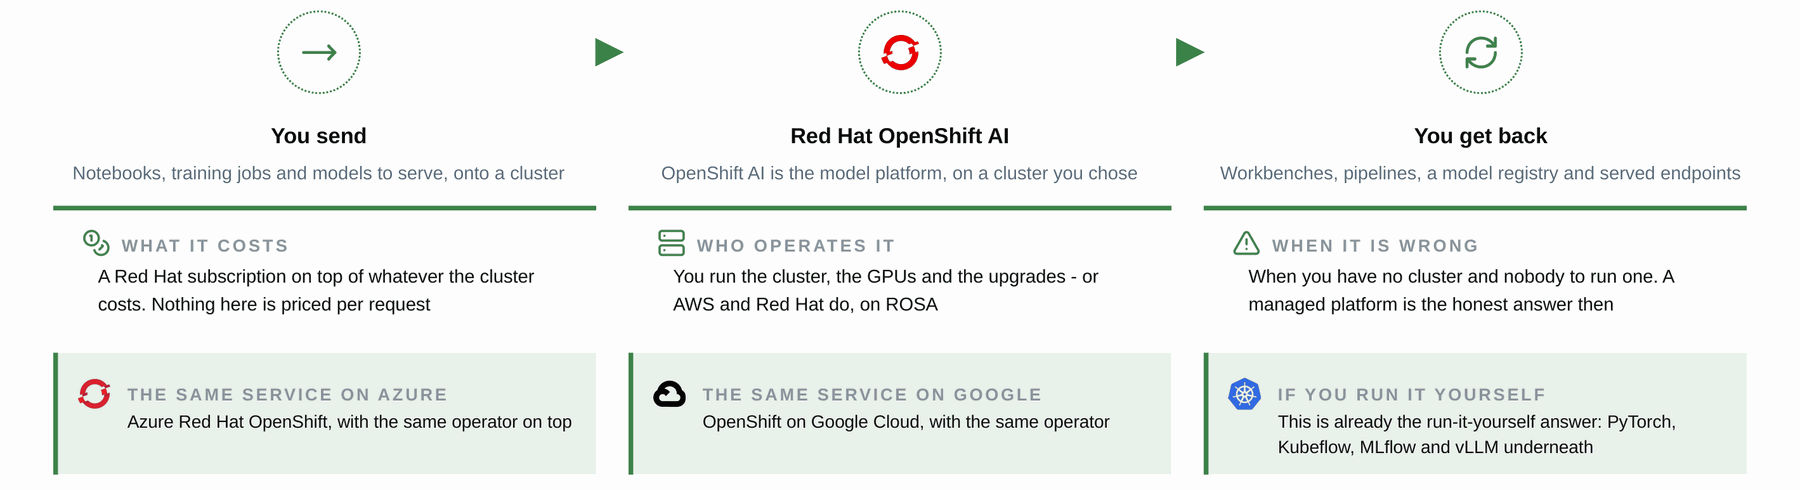
Die Plattform, die Sie selbst betreiben, on premises oder in einer Cloud. OpenShift AI bündelt Open-Source-Komponenten wie PyTorch, Kubeflow, MLflow und vLLM, mit Red-Hat-Support; Kubeflow und MLflow lassen sich auch ohne zusammenstellen.
Projektseite →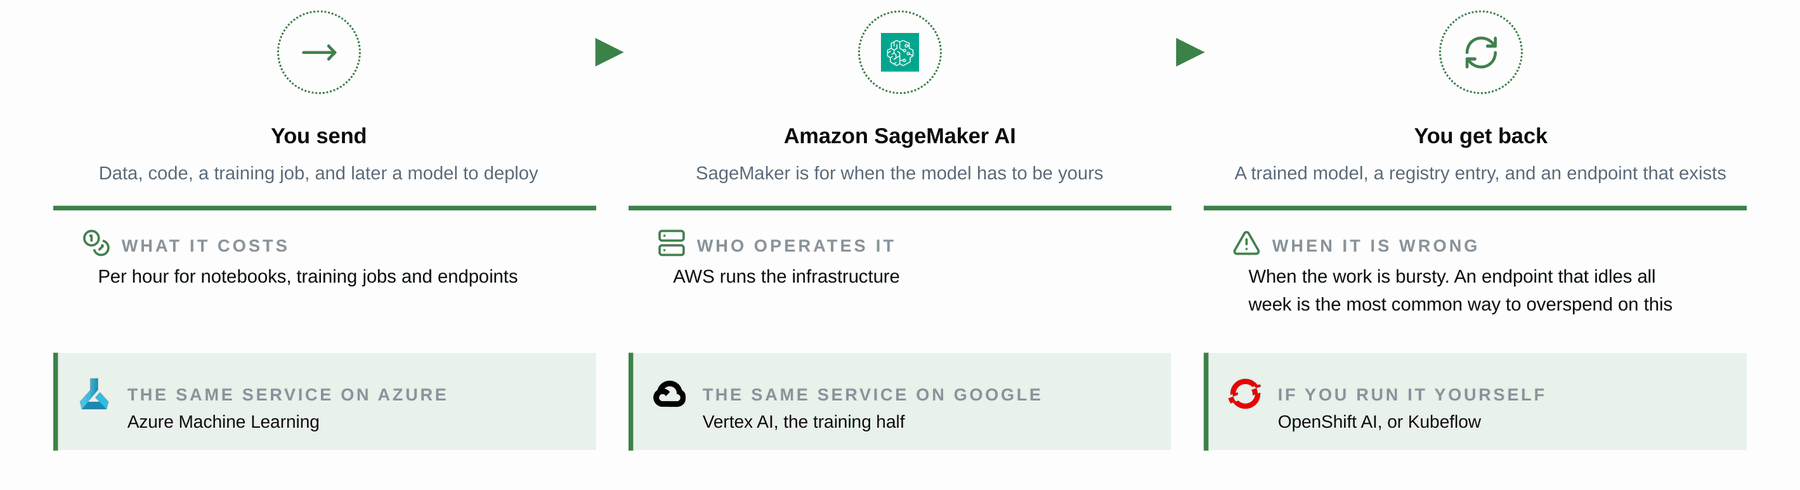
So sieht es in einer Architektur aus
Folien aus meiner Lehrveranstaltung zu KI-Architekturen an der FH Burgenland, aus echten Projekten (auf Englisch).
Wo ich es eingesetzt habe
Der Event-Assistent
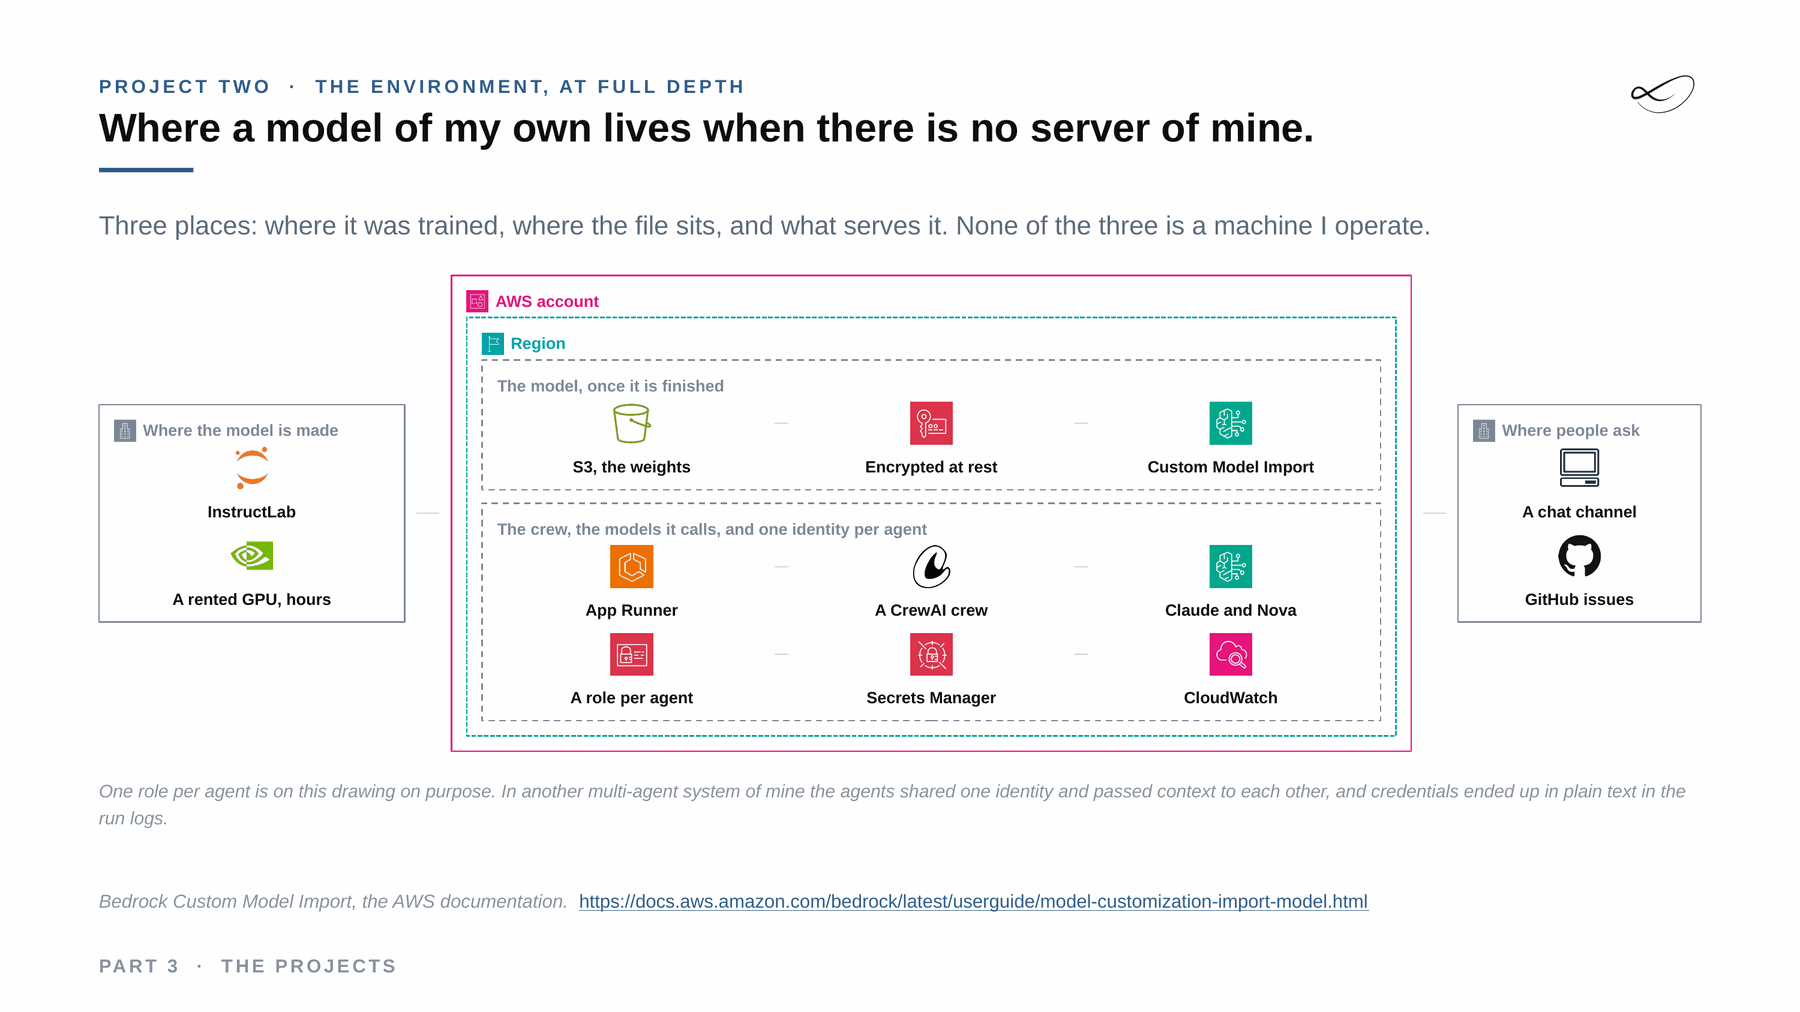
Mein Event-Assistent brauchte Wissen, das kein öffentliches Modell hat: die eigene Geschichte der Gruppe. Ich habe ein kleines offenes Modell mit InstructLab einige Stunden auf einer gemieteten GPU feinjustiert, die Gewichte in S3 abgelegt und stelle sie über Bedrock Custom Model Import bereit. Ein SageMaker-Endpunkt wurde geprüft und verworfen, weil er für jede Stunde kostet, die er existiert. Das ganze System läuft für etwa dreißig Euro im Monat.
Zu den Referenzprojekten →Verwaltet und selbst betrieben zusammen: Hybrid
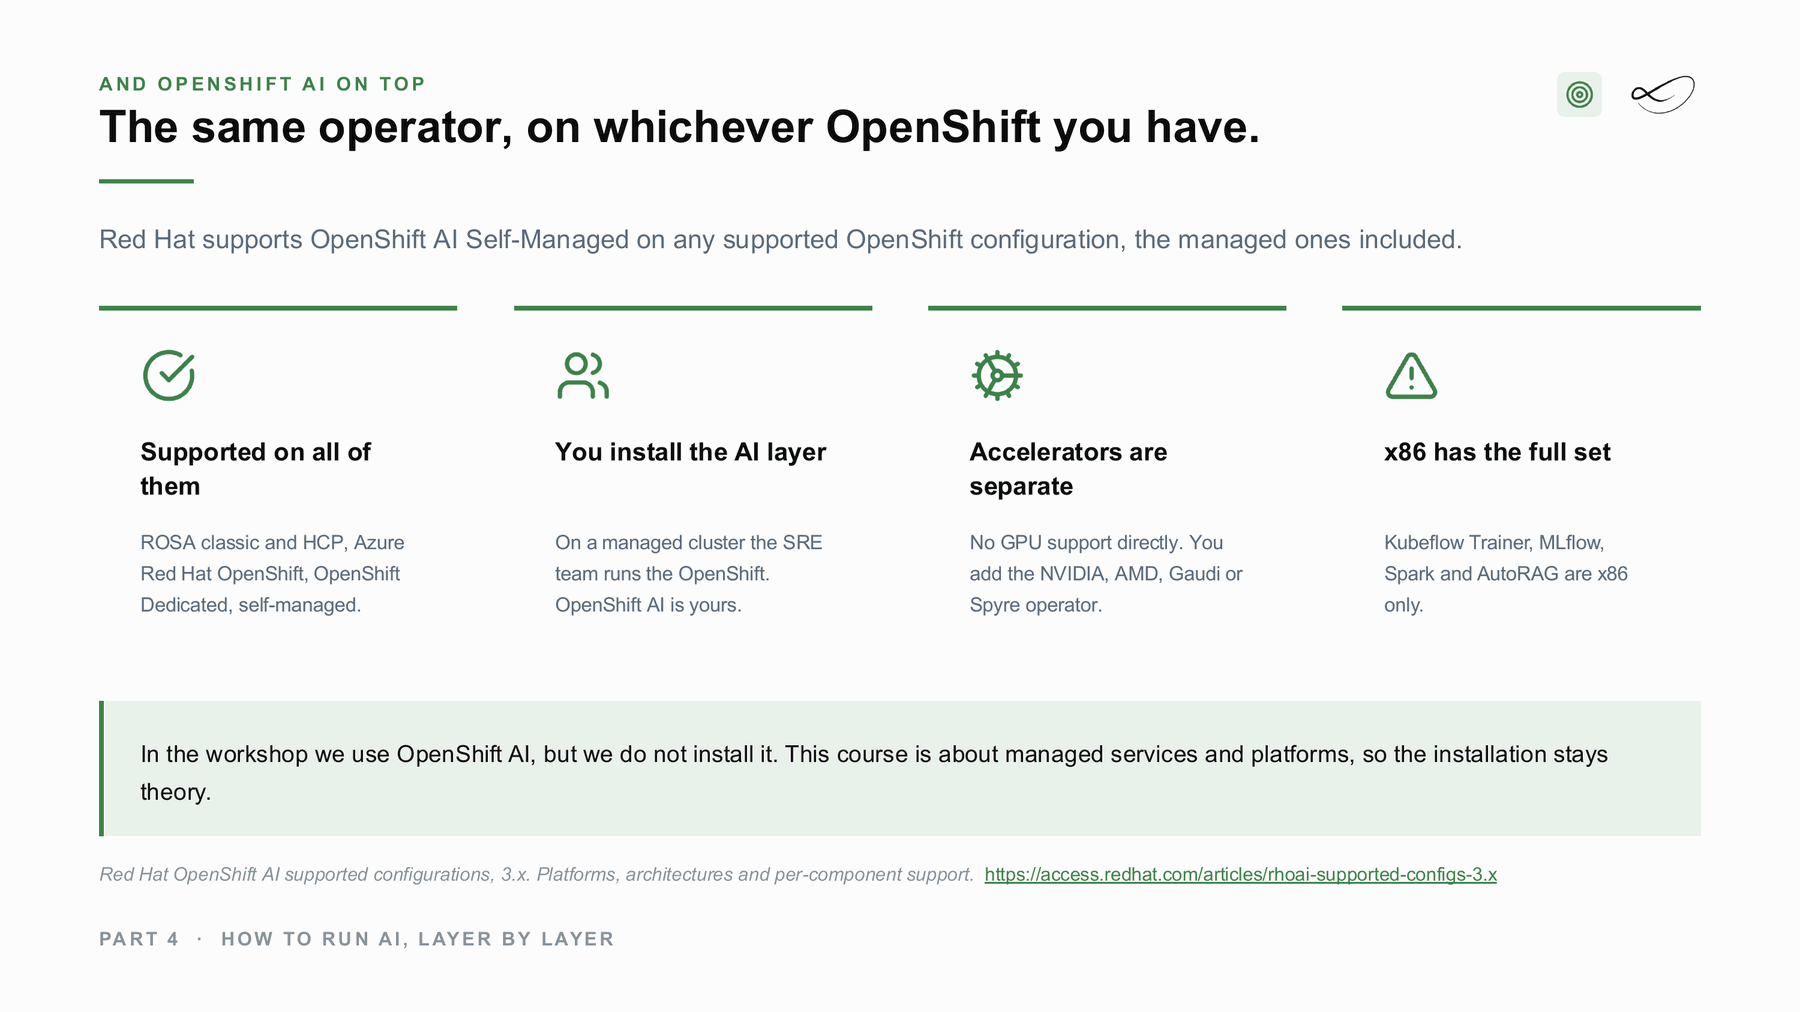
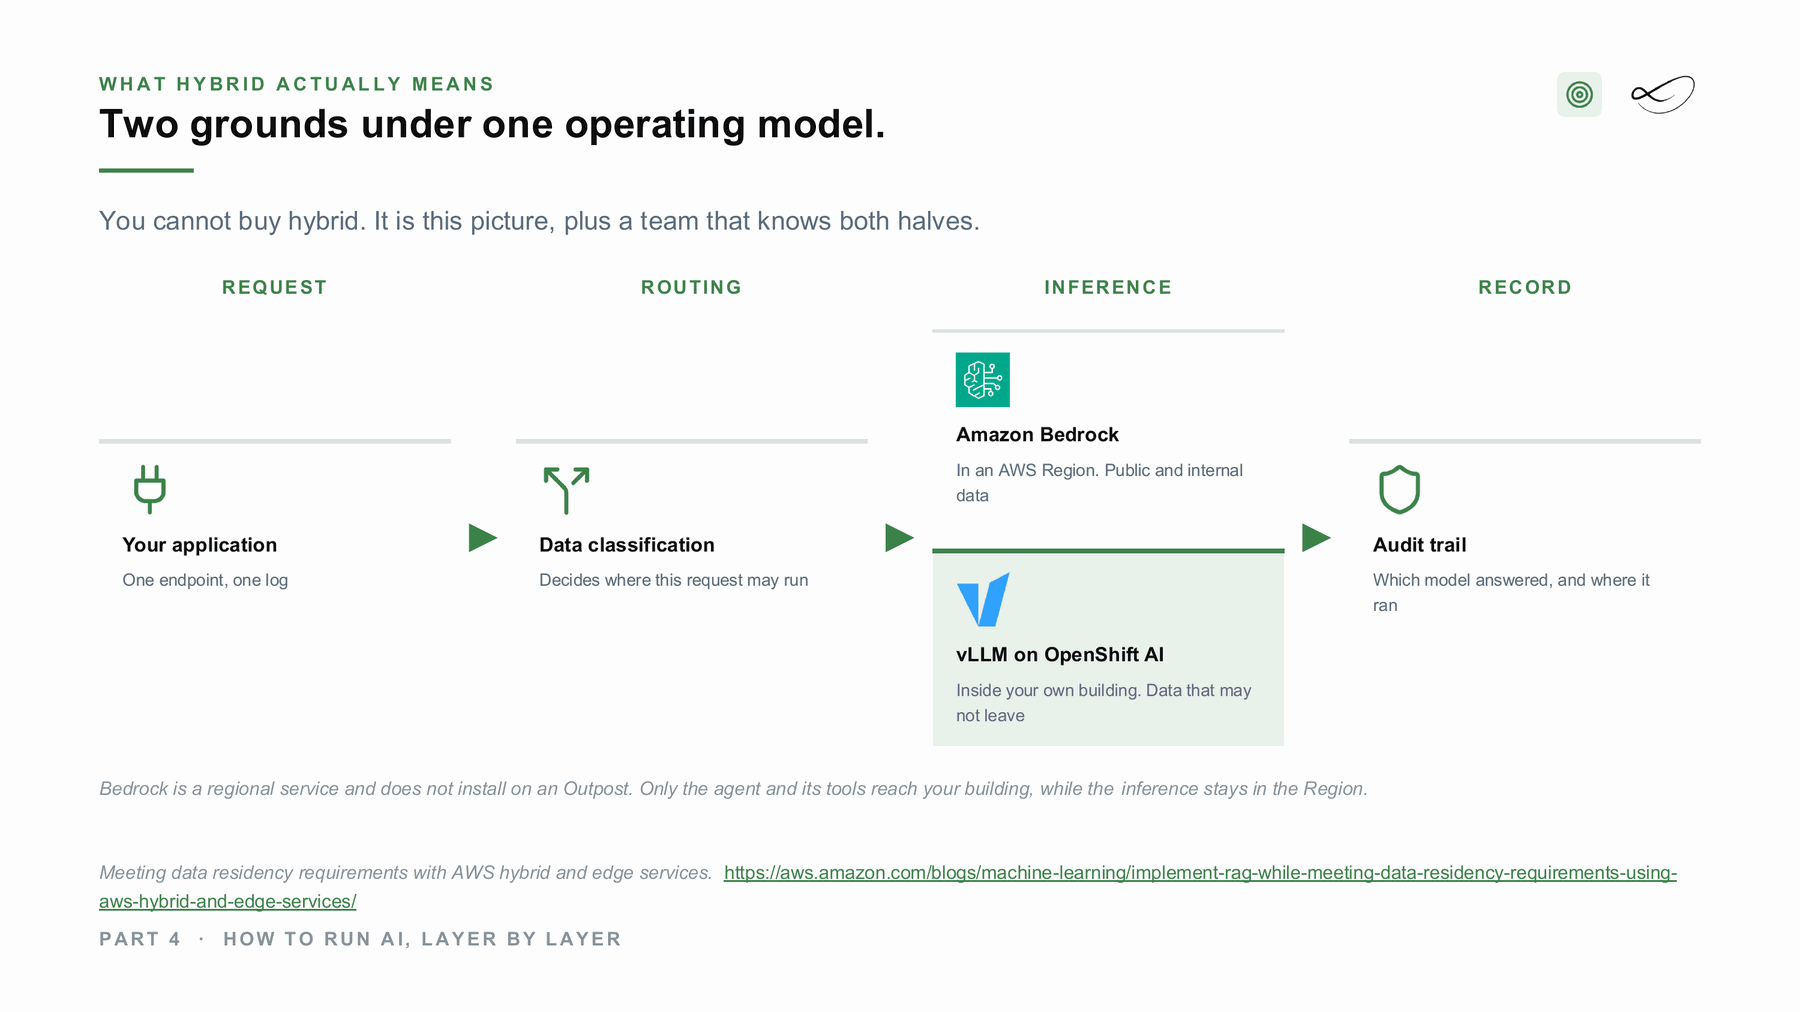
Bei einem eigenen Modell gehört Ihnen das Modell-Artefakt, und die Trainingsdaten dürfen vielleicht nicht hinaus. Das teilt die Arbeit: Training dort, wo die Daten sind, Bereitstellung dort, wo die Nutzer sind. Auf eigener Plattform heißt Hybrid dieselbe Plattform zweimal installiert, auf eigenen und auf gemieteten Maschinen, als eine betrieben. Red Hat unterstützt OpenShift AI Self-Managed auf den verwalteten OpenShift-Angeboten ebenso wie auf eigener Hardware.[7]
Was hilft Ihnen als Nächstes?
Entscheiden lernen
Der Kurs „From Managed to Hybrid“ zeigt, wo KI laufen sollte: was jede Ebene kostet, was Sie betreiben und wo Ihre Daten bleiben müssen. Er ist in Vorbereitung, mit einer kostenlosen Live-Session zum Start.
 Linda Mohamed
KI- und Cloud-Beraterin, AWS Community Hero, Wien
Gemeinsam bauen
Erzählen Sie mir, was Sie bauen wollen. In 30 Minuten prüfen wir, welcher der vier Wege zu Ihren Daten, Ihren Regeln und Ihrem Budget passt und ob AWS-Förderung für einen Proof of Concept einen Teil abdeckt. So funktioniert AWS-Förderung →
Sie wissen schon, was Sie brauchen
Buchen Sie direkt den Workshop:
- OpenShift-AI-on-AWS-Lab →
Ein geführtes Lab zu Red Hat OpenShift AI: Modelle auf der eigenen Plattform betreiben, neben Amazon Bedrock. - KI-Konzept- und Prototyp-Workshops →
Zuerst die Architektur, pro Service bepreist und mit Ihren Daten getestet, dann ein Prototyp mit Go- oder Stopp-Entscheidung.

Mehr auf ai-solutions.wiki
Meine offene Wissensbasis, mit längeren Vergleichen, Preisnotizen und Quellen (auf Englisch).
Quellen
- Amazon SageMaker AI Dokumentation. https://docs.aws.amazon.com/sagemaker/latest/dg/whatis.html
- Azure Machine Learning Dokumentation. https://learn.microsoft.com/en-us/azure/machine-learning/overview-what-is-azure-machine-learning
- Vertex AI Dokumentation. https://cloud.google.com/vertex-ai/docs
- Red Hat OpenShift AI, Kubeflow und MLflow. https://www.redhat.com/en/products/ai/openshift-ai
- Linda Mohamed, Kursfolien “The projects”, MASE-3, FH Burgenland, September 2026
- Linda Mohamed, Kursfolien “How to run AI, layer by layer”, MASE-3, FH Burgenland, September 2026
- Red Hat OpenShift AI supported configurations 3.x, Red Hat. https://access.redhat.com/articles/rhoai-supported-configs-3.x
- Amazon SageMaker, ai-solutions.wiki. https://ai-solutions.wiki/tools/amazon-sagemaker/
- Red Hat OpenShift AI, ai-solutions.wiki. https://ai-solutions.wiki/tools/openshift-ai/
- SageMaker vs Bedrock, ai-solutions.wiki. https://ai-solutions.wiki/comparisons/sagemaker-vs-bedrock/
- Custom ML models vs foundation models, ai-solutions.wiki. https://ai-solutions.wiki/comparisons/custom-ml-vs-foundation-models/
- Bedrock Custom Model Import, AWS documentation. https://docs.aws.amazon.com/bedrock/latest/userguide/model-customization-import-model.html
- InstructLab. https://instructlab.ai/
Links geprüft im September 2026. Produktnamen und Funktionen ändern sich: Prüfen Sie die verlinkten Seiten, bevor Sie entscheiden.