Bild- und Objekterkennung: was auf einem Bild ist
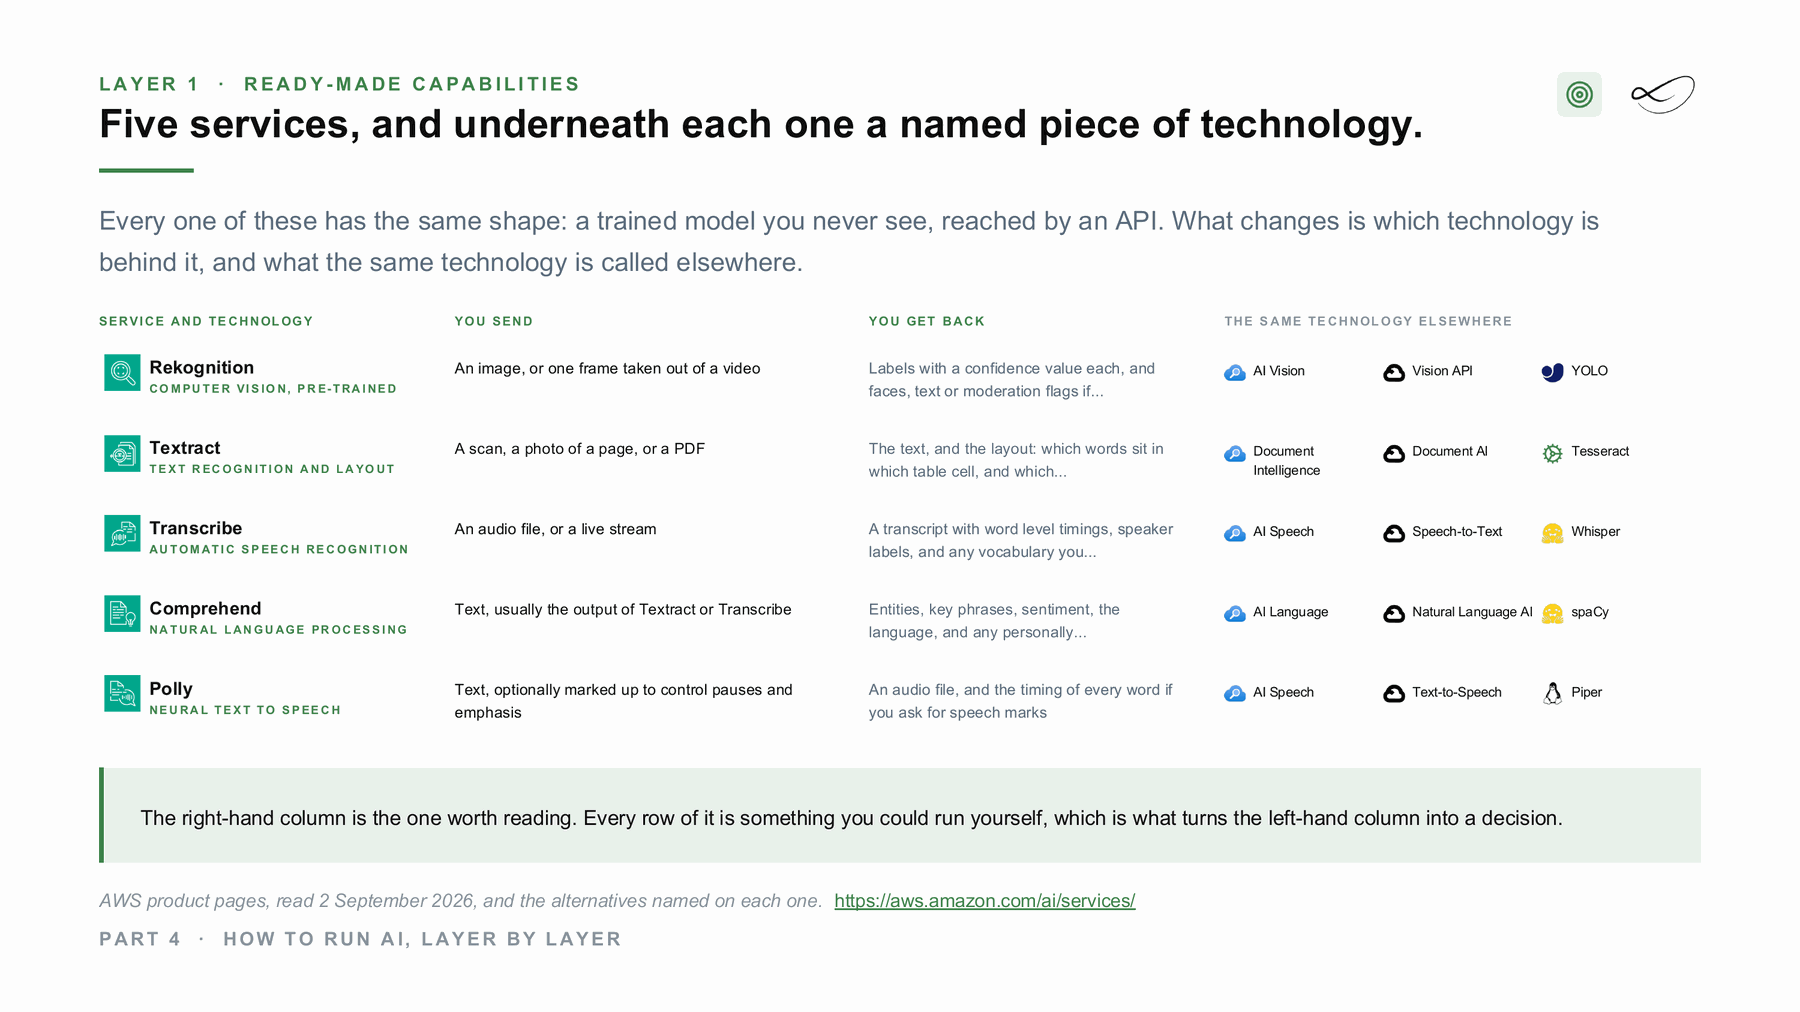
Computer-Vision-Modelle sehen sich ein Bild oder ein Video-Frame an und liefern, was sie erkennen: Objekte, Szenen, Text oder Gesichter, jeweils mit einem Konfidenzwert.


Was sind Bild- und Objekterkennung?
Bilderkennung beantwortet „Was ist auf diesem Bild?“ mit Labels. Objekterkennung geht einen Schritt weiter und liefert auch, wo jedes Objekt ist, als Rahmen darum. Beides funktioniert auf einzelnen Bildern und auf Frames aus einem Video.
Fertige Services kennen einen großen öffentlichen Satz an Labels. Wenn Ihre Objekte darin nicht vorkommen, trainieren Sie mit eigenen Beispielen, entweder im verwalteten Service oder mit einem offenen Modell auf Ihrer eigenen GPU.
Vier Wege, sie zu betreiben
Jede der großen Clouds bietet sie als verwalteten Service an, und Sie können sie auch selbst betreiben. Dieselbe Aufgabe, eine andere Rechnung und eine andere Konsole.
Amazon Rekognition[1]
Der verwaltete Bild- und Videoanalyse-Service auf AWS. Er liefert Labels, Text und Gesichter, und mit Custom Labels lernt er Objekte, die nur für Ihr Unternehmen zählen.
Offizielle Dokumentation →Azure AI Vision[2]
Der verwaltete Computer-Vision-Service auf Microsoft Azure für Bildanalyse und das Lesen von Text in Bildern.
Offizielle Dokumentation →Cloud Vision API und Video Intelligence[3]
Die verwaltete Bildanalyse-API auf Google Cloud, mit einer eigenen Video Intelligence API für Video.
Offizielle Dokumentation →YOLO von Ultralytics[4]
Eine Familie offener Objekterkennungsmodelle, die Sie auf Ihrer eigenen GPU betreiben. Ultralytics veröffentlicht sie unter AGPL-3.0, mit Enterprise-Lizenz für geschlossene Produkte.
Projektseite →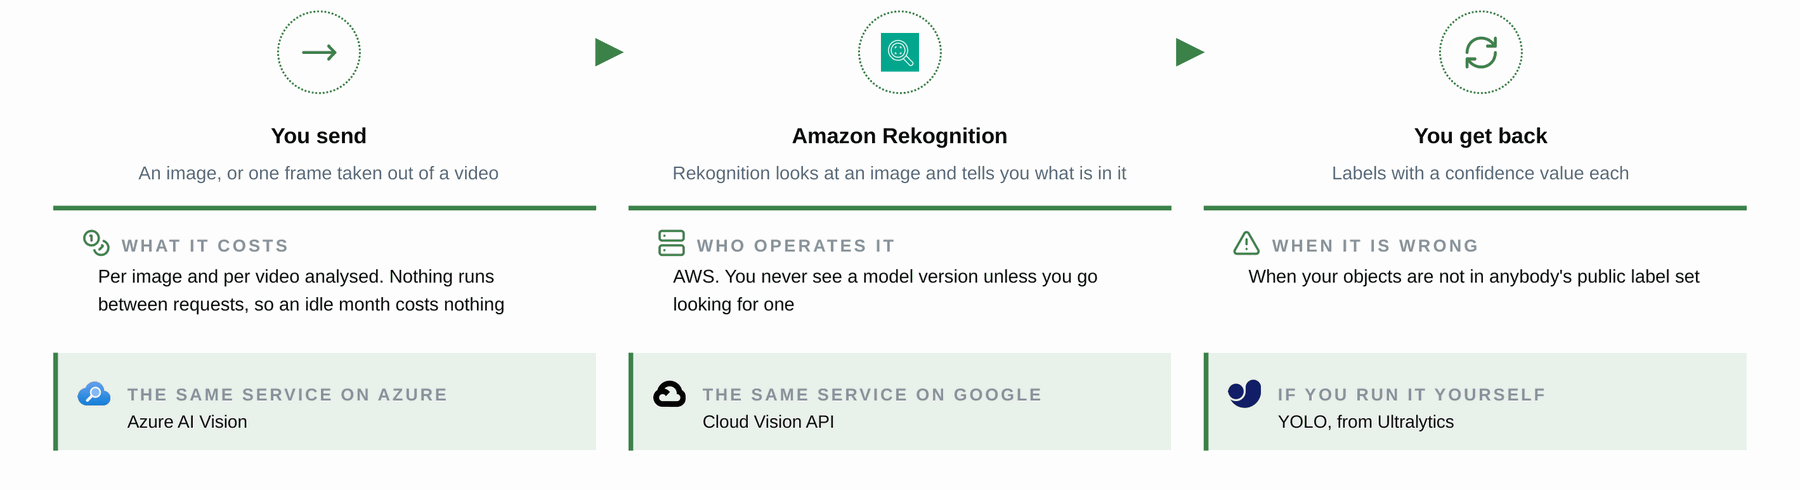
So sieht es in einer Architektur aus
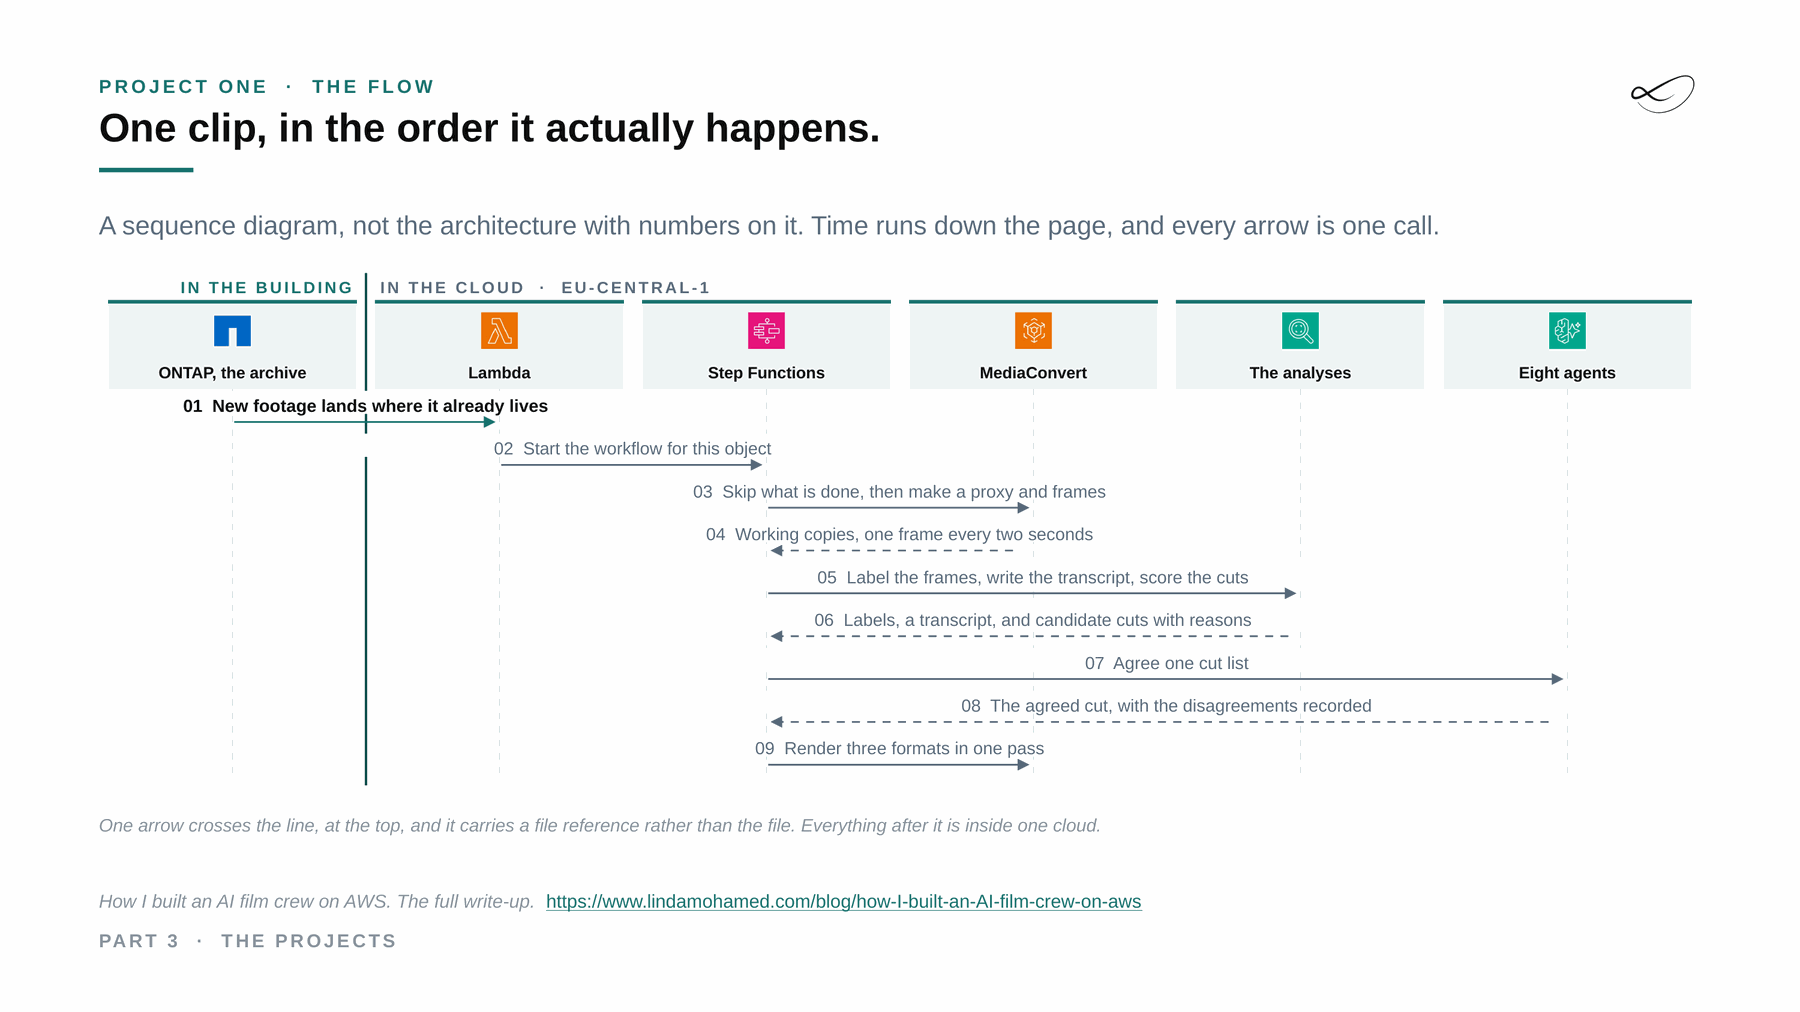
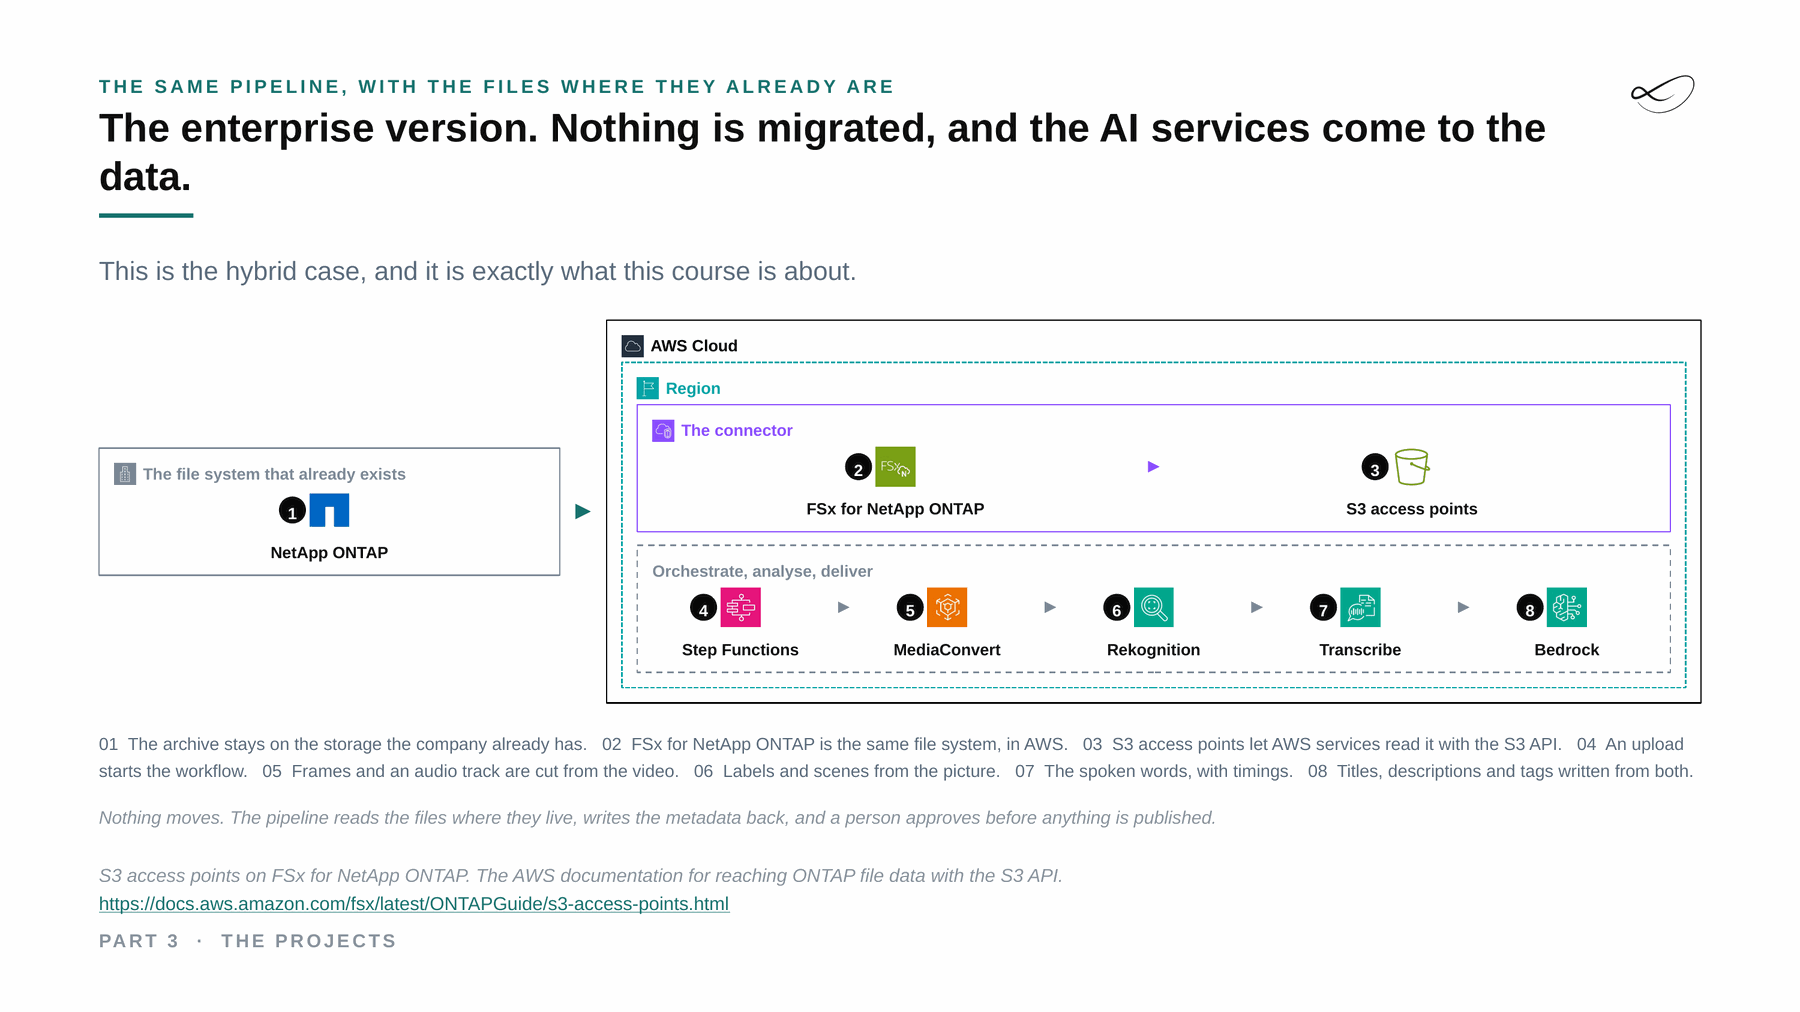
Folien aus meiner Lehrveranstaltung zu KI-Architekturen an der FH Burgenland, aus echten Projekten (auf Englisch).
Wo ich es eingesetzt habe
Die Video-Pipeline
In meiner Video-Pipeline labelt Rekognition alle zwei Sekunden ein Frame, für etwa 7 Cent pro Clip. Die Labels sind einer der Inputs, mit denen die Agenten entscheiden, welche Szenen in den Schnitt kommen.
Zum Bericht (Englisch) →Verwaltet und selbst betrieben zusammen: Hybrid
Bei einem fertigen Service verlässt der Aufruf Ihr Netzwerk. Die Hybrid-Entscheidung ist, was hinausgeht und in welchem Zustand: die ganze Datei, eine geschwärzte oder nur der Teil, der muss. Wo eine Datei gar nicht hinaus darf, läuft derselbe Schritt mit der Open-Source-Option in Ihrem Gebäude, und nur das Ergebnis, oder nichts, geht hinaus.[7]
Was hilft Ihnen als Nächstes?
Entscheiden lernen
Der Kurs „From Managed to Hybrid“ zeigt, wo KI laufen sollte: was jede Ebene kostet, was Sie betreiben und wo Ihre Daten bleiben müssen. Er ist in Vorbereitung, mit einer kostenlosen Live-Session zum Start.
 Linda Mohamed
KI- und Cloud-Beraterin, AWS Community Hero, Wien
Gemeinsam bauen
Erzählen Sie mir, was Sie bauen wollen. In 30 Minuten prüfen wir, welcher der vier Wege zu Ihren Daten, Ihren Regeln und Ihrem Budget passt und ob AWS-Förderung für einen Proof of Concept einen Teil abdeckt. So funktioniert AWS-Förderung →
Sie wissen schon, was Sie brauchen
Buchen Sie direkt den Workshop:
- KI-Konzept- und Prototyp-Workshops →
Zuerst die Architektur, pro Service bepreist und mit Ihren Daten getestet, dann ein Prototyp mit Go- oder Stopp-Entscheidung. - KI-Discovery-Workshop →
Ihre Ideen als bewertete Shortlist, damit Sie wissen, welcher Anwendungsfall zuerst kommt.

Mehr auf ai-solutions.wiki
Meine offene Wissensbasis, mit längeren Vergleichen, Preisnotizen und Quellen (auf Englisch).
Quellen
- Amazon Rekognition Dokumentation. https://docs.aws.amazon.com/rekognition/latest/dg/what-is.html
- Azure AI Vision Dokumentation. https://learn.microsoft.com/en-us/azure/ai-services/computer-vision/overview
- Cloud Vision API und Video Intelligence Dokumentation. https://cloud.google.com/vision/docs
- YOLO von Ultralytics. https://docs.ultralytics.com/
- Linda Mohamed, Kursfolien “The projects”, MASE-3, FH Burgenland, September 2026
- Linda Mohamed, Kursfolien “How to run AI, layer by layer”, MASE-3, FH Burgenland, September 2026
- S3 access points on FSx for NetApp ONTAP, AWS documentation. https://docs.aws.amazon.com/fsx/latest/ONTAPGuide/s3-access-points.html
- Amazon Rekognition, ai-solutions.wiki. https://ai-solutions.wiki/tools/amazon-rekognition/
- Azure Computer Vision, ai-solutions.wiki. https://ai-solutions.wiki/tools/azure-computer-vision/
- YOLO (Ultralytics), ai-solutions.wiki. https://ai-solutions.wiki/tools/yolo/
- Pre-built AI services vs foundation models, ai-solutions.wiki. https://ai-solutions.wiki/comparisons/prebuilt-ai-services-vs-foundation-models/
Links geprüft im September 2026. Produktnamen und Funktionen ändern sich: Prüfen Sie die verlinkten Seiten, bevor Sie entscheiden.